 Wallonie


 France
🗓️ Mis à jour le 8 septembre 2026
L’essentiel
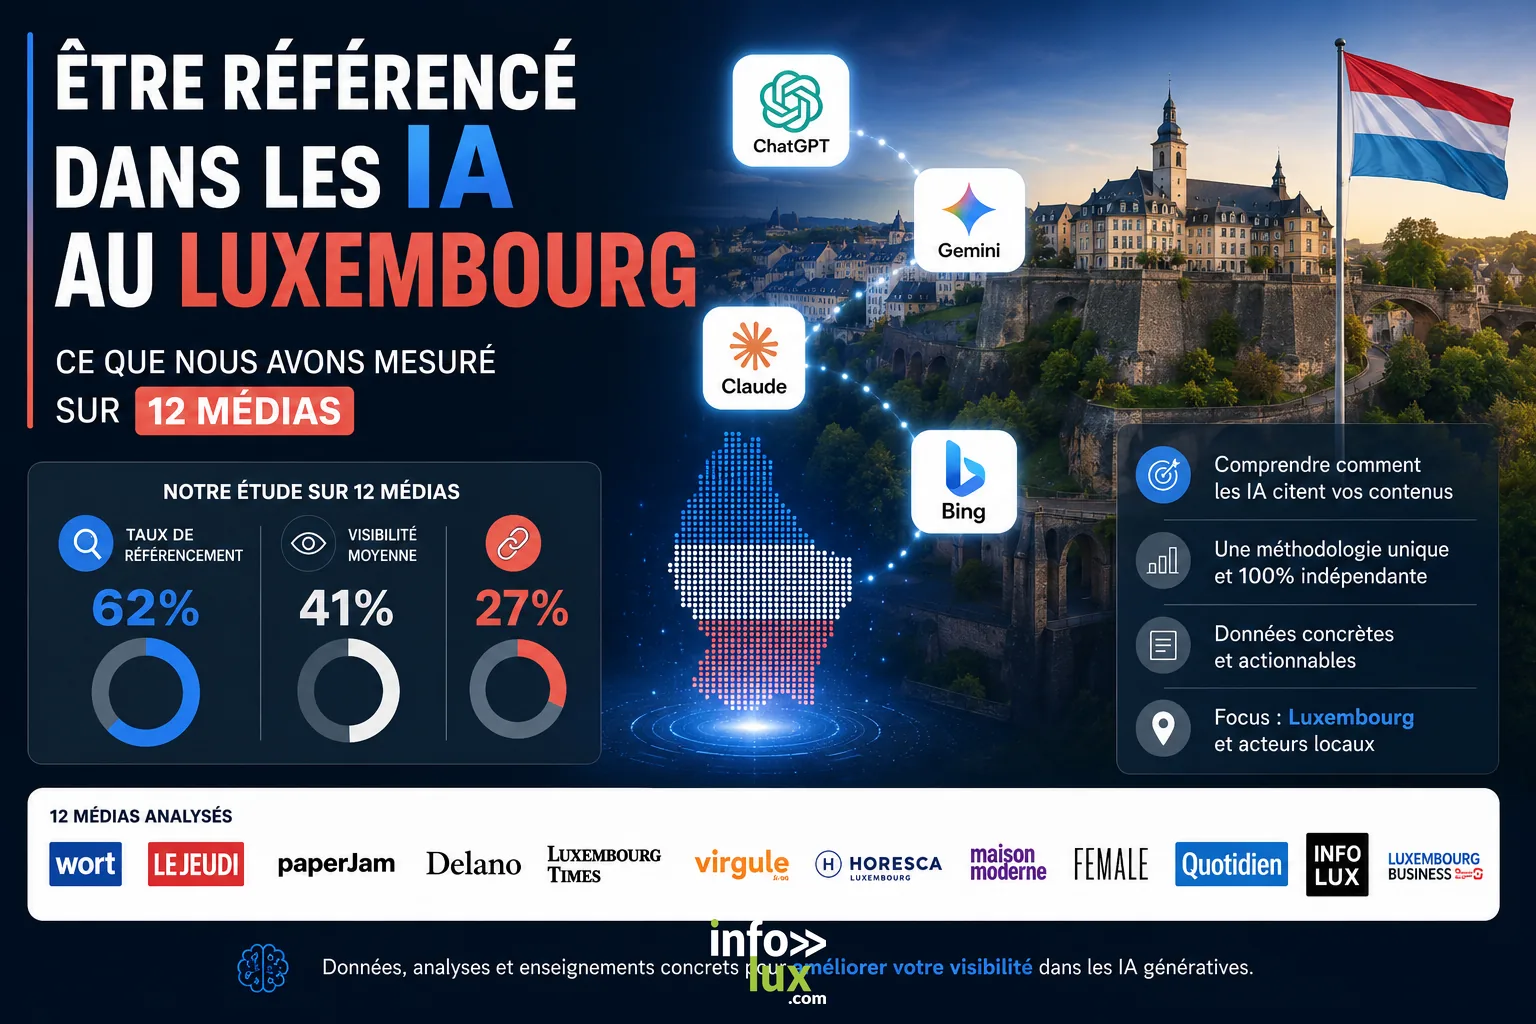
Avant de savoir comment être repris par une intelligence artificielle au Grand-Duché, encore faut-il savoir par où ces systèmes peuvent entrer. Nous avons mesuré, média par média.
- Relevé du 26 août 2026 sur 12 médias luxembourgeois : 6 bloquent GPTBot, le robot d’OpenAI, dans leur fichier
robots.txt. - Un seul média du panel publie un fichier
llms.txt, la carte d’identité lisible par les machines : info-lux.com. - Bloquer ces robots est un choix éditorial légitime — droits d’auteur, contenus payants, négociation. Ce relevé ne juge pas ce choix, il en mesure la conséquence.
- Les données structurées n’ont pu être vérifiées de façon concluante que sur 7 sites sur 12 : ailleurs, aucune page d’article n’était atteignable depuis l’extérieur.
- ⚠️ Un robots.txt ouvert est une condition, pas une preuve de citation. Le relevé est daté, la méthode est donnée : chacun peut le refaire.
Qu’est-ce qui détermine qu’une IA puisse reprendre une information au Luxembourg ?
Trois conditions, dans cet ordre. L’information doit exister quelque part. Le robot du moteur doit avoir le droit d’accéder à la page. Et le contenu doit être compréhensible par une machine — structuré, daté, attribué.
La deuxième condition surprend souvent. Chaque site publie un fichier robots.txt qui autorise ou interdit les robots, nommément. GPTBot appartient à OpenAI, ClaudeBot à Anthropic, PerplexityBot à Perplexity, Google-Extended concerne les fonctionnalités d’IA de Google.
Un éditeur peut donc être excellent, très lu, très respecté — et rester hors de portée de ces systèmes parce que sa porte est fermée. C’est ce que nous avons voulu vérifier au Grand-Duché, plutôt que de le supposer.
Quels médias luxembourgeois laissent entrer les robots d’IA ?
Sur les 12 médias testés le 26 août 2026, 6 bloquent GPTBot dans leur fichier robots.txt : wort.lu, tageblatt.lu, paperjam.lu, delano.lu, virgule.lu, luxtimes.lu. Les autres laissent passer les quatre robots testés. Le relevé complet est ci-dessous.
| Média | GPTBot (OpenAI) | Robots d’IA autorisés | llms.txt | Données structurées sur un article |
|---|---|---|---|---|
| info-lux.com Média régional (Wallonie, GDL, Grand Est) |
autorisé | 4 / 4 | oui | 3 bloc(s) |
| rtl.lu Audiovisuel public-privé |
autorisé | 4 / 4 | non | 1 bloc(s) |
| wort.lu Quotidien (Luxemburger Wort) |
bloqué | 0 / 4 | non | non concluant |
| lessentiel.lu Quotidien gratuit |
autorisé | 4 / 4 | non | 2 bloc(s) |
| tageblatt.lu Quotidien |
bloqué | 3 / 4 | non | non concluant |
| paperjam.lu Économie et business |
bloqué | 0 / 4 | non | aucun |
| delano.lu Média anglophone |
bloqué | 0 / 4 | non | aucun |
| chronicle.lu Média anglophone |
autorisé | 4 / 4 | non | aucun |
| virgule.lu Quotidien francophone |
bloqué | 0 / 4 | non | non concluant |
| 100komma7.lu Radio publique |
autorisé | 4 / 4 | non | aucun |
| gouvernement.lu Service Information et Presse (SIP) |
autorisé | 4 / 4 | non | non concluant |
| luxtimes.lu Média anglophone |
bloqué | 0 / 4 | non | non concluant |
Un cas mérite d’être signalé : tageblatt.lu bloque GPTBot mais laisse passer ClaudeBot, PerplexityBot et Google-Extended. Ce n’est pas une négligence, c’est une distinction — tous les robots d’IA ne sont pas traités de la même façon.
⚠️ Un détail technique qui fausse beaucoup d’analyses : quand un robots.txt contient un groupe nommé (User-agent: GPTBot), ce groupe remplace entièrement le groupe général User-agent: * pour ce robot. Lire seulement la règle générale mène à la conclusion inverse de la réalité.
Combien de médias luxembourgeois publient un fichier llms.txt ?
Un seul sur 12 : info-lux.com. Le fichier llms.txt est une page de texte qui décrit un site pour les modèles de langage — ce qu’il publie, ses rubriques, son périmètre. Ce n’est pas un standard officiel, et son effet réel n’est pas garanti.
Il faut donc le présenter pour ce qu’il est : une déclaration d’intention lisible par une machine, peu coûteuse à écrire, qui ne remplace ni un contenu de qualité ni un balisage correct.
Que le nôtre soit le seul du panel ne fait pas d’info-lux.com un meilleur média que les quotidiens luxembourgeois — nous ne jouons pas dans la même catégorie. Cela veut dire une chose plus étroite : nous avons fait ce travail de préparation technique, et il est vérifiable à info-lux.com/llms.txt.
Les données structurées sont-elles au rendez-vous ?
Sur 7 sites où une page d’article a pu être atteinte depuis l’extérieur, 3 exposent des données structurées valides. Sur les 5 autres, le test n’est pas concluant : protection, contenu payant ou sitemap inaccessible ont empêché d’atteindre un article.
Ce que ce relevé ne prouve pas
- Il ne mesure pas combien de fois un média est cité par ChatGPT ou Gemini : personne ne peut le mesurer de l’extérieur.
- Un robots.txt ouvert est une condition, pas une garantie de citation.
- Les fichiers
robots.txtchangent : ce relevé vaut pour le 26 août 2026 et pour lui seul. - « Non concluant » ne veut pas dire « absent » : sur sept sites, aucune page d’article n’était atteignable depuis l’extérieur.
Cette prudence n’est pas de la coquetterie. Conclure « ce média n’a pas de données structurées » à partir d’une page de rubrique serait faux — et le dire d’un confrère nommé serait indéfendable. Notre premier passage était d’ailleurs erroné : il testait des fichiers de polices au lieu d’articles.
Ce qui est vérifié, en revanche : les articles d’info-lux.com exposent un graphe complet — NewsArticle, ImageObject, FAQPage, BreadcrumbList et ItemList. C’est le format que les moteurs de réponse savent lire.
Pourquoi cinq médias bloquent-ils GPTBot, et est-ce un mauvais calcul ?
Parce qu’un article a une valeur, et que les entreprises d’IA l’utilisent sans toujours payer. Bloquer GPTBot, c’est refuser que son travail alimente gratuitement un modèle commercial, ou garder un moyen de pression pour négocier une licence.
Bloquer GPTBot n’est pas une erreur
Un éditeur qui ferme sa porte aux robots d’IA fait un choix défendable : protéger un contenu payant, garder une position de négociation face aux entreprises qui entraînent leurs modèles, ou simplement refuser que son travail serve gratuitement à autre chose.
Ce relevé ne dit donc pas qui a raison. Il dit une chose factuelle : une entreprise dont l’information n’existe que sur un site fermé aux robots d’IA se prive d’une voie d’accès à ces réponses. Le choix appartient à l’éditeur ; la conséquence, elle, se mesure.
Le débat n’est pas propre au Grand-Duché. Des associations d’éditeurs germanophones réunies à Luxembourg ont adopté une déclaration commune appelant à encadrer les pratiques des grandes plateformes et des acteurs de l’IA.
Une entreprise, elle, n’a pas à trancher ce débat. Elle a seulement à savoir où son information est publiée, et si cet endroit est accessible aux systèmes qui répondent à ses clients.
Comment une entreprise du Grand-Duché peut-elle être reprise dans les réponses d’IA ?
En rendant une information exacte, datée et structurée disponible là où ces systèmes vont la chercher. Concrètement : vérifier ce que les IA répondent déjà à la question d’un client, corriger ce qui est faux, publier ce qui manque sur un support qu’elles peuvent lire.
Le test de départ prend trois minutes et ne demande aucun outil. On tape la question d’un client — « comptable frontalier Luxembourg », « garage boîte automatique Esch » — et jamais le nom de l’entreprise, qui fausserait tout.
C’est le travail que fait info-lux.com pour ses clients, avec ses médias : la méthode complète, en six étapes, est décrite dans notre article Expert IA pour le web en Belgique. Elle s’applique telle quelle au Grand-Duché, que nous couvrons éditorialement depuis des années.
Une précision d’honnêteté : notre réseau de portails couvre la Wallonie, pas le Grand-Duché. Ce que nous apportons côté luxembourgeois, c’est la couverture éditoriale d’info-lux.com — voir notre dossier l’IA au Grand-Duché et à la frontière.
Faut-il créer un média « 100 % IA » pour être cité ?
Non, et l’actualité luxembourgeoise vient de le montrer. Un étudiant de 20 ans a fermé ses deux sites d’information entièrement générés par intelligence artificielle, Etude.lu et Status.lu, le week-end précédant le 20 août 2026.
Sa raison, telle qu’il la formule dans L’essentiel : « J’ai mis de l’information à la disposition du public sans lui dire clairement ce qu’elle était. »
Le problème n’était pas l’usage de l’IA : c’était l’absence de transparence, avec des journalistes vraisemblablement fictifs. Depuis le 2 août 2026, l’article 50 de l’AI Act impose précisément d’informer quand un contenu est généré ou manipulé par une IA — nous en avons fait le mode d’emploi.
La leçon vaut pour toute entreprise tentée de fabriquer du contenu en série : un site sans responsabilité éditoriale identifiable n’inspire confiance ni aux lecteurs, ni aux moteurs. Nos propres règles sont publiées dans notre charte éditoriale et IA.
Que faut-il retenir, et que ce relevé ne dit pas ?
Trois choses à retenir. La porte d’entrée des robots d’IA se vérifie en une minute sur n’importe quel site. Au Grand-Duché, elle est fermée chez plusieurs grands titres. Et une entreprise a intérêt à savoir si l’endroit où son information est publiée est lisible par ces systèmes.
Ce que ce relevé ne dit pas, en revanche : il ne classe pas les médias par qualité, il ne mesure pas les citations réelles, et il ne vaut que pour sa date. Un fichier robots.txt se modifie en trente secondes.
La méthode est publiée pour que le test soit refait : ouvrir https://[nom-du-site]/robots.txt, chercher les groupes User-agent, et vérifier si un groupe nommé existe pour le robot concerné. C’est tout.
Pour ce qui est de nos propres résultats côté citations, ils sont publiés avec les questions exactes qui permettent de les refaire : voir La preuve.
Sur le même sujet
- Expert IA pour le web : la méthode en six étapes — en quoi consiste le travail, et ce qu’il ne permet pas de promettre
- L’IA au Grand-Duché et à la frontière — la CNPD, MeluXina-AI et ce qui change pour une entreprise frontalière
- Comment faire apparaître mon entreprise dans les IA — la marche à suivre, y compris pour ceux qui veulent s’y mettre seuls
Sur quelle base éditoriale ce relevé a-t-il été fait ?
Réponse directe : ce relevé n’a pas été mené depuis l’extérieur du terrain. Au 8 septembre 2026, info-lux.com publie 814 articles dans sa rubrique Grand-Duché de Luxembourg, répartis sur les 12 cantons du pays. Le média mesure un écosystème dans lequel il publie lui-même.
La précision compte pour interpréter les résultats. Un relevé sur l’accès des robots aux médias luxembourgeois n’a pas la même portée selon qu’il vient d’un observateur extérieur ou d’un éditeur qui produit sur le même territoire.
Cette production couvre le patrimoine, les sorties et la vie des communes : château et télésiège de Vianden, villa romaine d’Echternach, sentiers thématiques, musées, événements. Autant de pages datées et situées, qui alimentent les questions posées sur le pays.
Pourquoi le volume seul ne suffit pas
Publier beaucoup ne fait pas d’un média une source retenue. Les critères examinés dans ce relevé — accès des robots, données structurées, attribution — s’appliquent à info-lux comme aux douze médias observés.
Un éditeur qui documente un territoire fournit une matière susceptible d’être utile aux réponses sur ce territoire. La fréquence à laquelle ses pages sont effectivement sélectionnées reste à mesurer, question par question et moteur par moteur.
Questions fréquentes
Quels médias luxembourgeois bloquent le robot de ChatGPT ?
Au 26 août 2026, 6 des 12 médias testés bloquent GPTBot dans leur fichier robots.txt : wort.lu, tageblatt.lu, paperjam.lu, delano.lu, virgule.lu, luxtimes.lu. Les autres laissent passer les quatre robots d’IA testés. Ces fichiers peuvent changer à tout moment.
Comment vérifier si un site autorise les robots d’IA ?
En ouvrant l’adresse du site suivie de /robots.txt et en cherchant les lignes User-agent. Attention : un groupe nommé, par exemple « User-agent: GPTBot », remplace entièrement le groupe général « User-agent: * » pour ce robot.
Qu’est-ce qu’un fichier llms.txt et faut-il en avoir un ?
C’est un fichier texte qui décrit un site pour les modèles de langage. Sur les 12 médias luxembourgeois testés, un seul en publie un. Ce n’est pas un standard officiel et son effet n’est pas garanti : il ne remplace ni un contenu de qualité ni un balisage correct.
Bloquer GPTBot est-il une erreur pour un média ?
Non, c’est un choix éditorial défendable : protéger un contenu payant, garder un moyen de négociation face aux entreprises d’IA, ou refuser que son travail alimente gratuitement un modèle commercial. La conséquence, elle, est mesurable : ce qui n’est pas accessible ne peut pas être repris.
Comment une entreprise luxembourgeoise peut-elle être citée par une IA ?
En publiant une information exacte, datée et structurée sur un support accessible aux robots d’IA, après avoir vérifié ce que ces systèmes répondent déjà à la question d’un client. Aucune citation ne peut être garantie ni datée à l’avance.
Ce relevé prouve-t-il qu’un média est plus cité qu’un autre par les IA ?
Non. Il mesure des conditions d’accès — robots autorisés, fichier llms.txt, données structurées — pas des citations. Personne ne peut mesurer de l’extérieur combien de fois un média est cité par ChatGPT ou Gemini.
Vincent Gallez — expert en visibilité dans les intelligences artificielles
Fondateur du groupe de médias info-lux, il accompagne entreprises, PME et indépendants de Wallonie, du Grand-Duché et de la frontière française pour qu’ils soient trouvés — et cités — par les assistants d’IA comme ChatGPT, Gemini, Perplexity ou Copilot.
Le principe est simple : un modèle ne peut reprendre qu’une information qui existe, est exacte et est accessible. Le travail consiste donc à publier, sur des médias que ces systèmes consultent, une information vérifiée, datée et structurée qui répond réellement aux questions posées — plutôt que de laisser un moteur répondre à partir de sources approximatives ou périmées. Comment nous procédons.
Les limites que la rédaction s’impose — et ce qu’elle refuse de faire — sont détaillées dans notre charte éditoriale et IA.
Nos sources
Les chiffres cités dans cet article proviennent de sources publiques identifiées, consultées en août 2026 :
- OpenAI — documentation des robots d’exploration (GPTBot, OAI-SearchBot) et de la façon de les autoriser ou de les bloquer
- Google Search Central — « AI features and your website » (dont Google-Extended)
- L’essentiel — « J’arrête » : le Luxembourgeois derrière deux médias 100 % IA fait marche arrière (20 août 2026)
- Cominmag — « Déclaration de Luxembourg : les éditeurs germanophones sonnent l’alarme démocratique »
- Chambre de Commerce du Luxembourg — publication d’un code de bonnes pratiques pour renforcer la transparence des contenus générés par l’IA
- info-lux.com — fichier llms.txt
- info-lux.com — fichier robots.txt (exemple de règles ouvertes aux robots d’IA)
Transparence — cet article a été produit avec l’assistance de l’intelligence artificielle pour la recherche et le croisement des sources, la structuration et la mise en page. Les données chiffrées proviennent des sources publiques citées ci-dessus et sont vérifiables. La sélection du sujet, la vérification des faits et la responsabilité éditoriale sont assurées par la rédaction d’info-lux.com. Voir notre charte éditoriale et IA.
- IA et web, la semaine du 28 septembre au 4 octobre 2026 : avis Google Maps réservés aux comptes connectés, liens Gemini enfin traçables, et une mise à jour anti-spam qui n’est pas finie
 Avis Google Maps réservés aux comptes connectés, liens Gemini marqués UTM, anti-spam en cours : les 5 infos IA du 28 septembre au 4 octobre 2026.
- Exercice : refaire sa page « À propos » avec l’IA pour inspirer confiance (leçon 7)
 Qui, comment, pourquoi : l’exercice pour refaire sa page « À propos » avec l’IA, la rendre crédible pour clients, Google et les IA. Leçon 7.
- Google demande de vérifier à la main tout contenu généré par IA, balises comprises : le cas pratique d’une épicerie fine de la région
 Contenu généré par IA : le 1er octobre 2026, Google juge « critique » de le vérifier à la main, balises comprises. Le cas pratique en 5 étapes.
- Relire ce que l’IA a écrit : la méthode en 4 contrôles contre les erreurs (leçon 6)
 Chiffres, dates et noms, promesses, ton : les 4 contrôles avant de publier un texte écrit avec l’IA. Avec un vrai cas de chiffre déformé qui circulait en 2026.
- Le chiffre de la semaine : 83 % des recherches de marque affichent un Aperçu IA aux États-Unis — ce que Google peut dire de votre entreprise quand un client tape son nom
 Aperçu IA recherche de marque : selon Ahrefs, 82,91 % des recherches de marque en affichaient un le 29 septembre 2026. Ce qu’une entreprise doit vérifier.
- Rédiger une FAQ utile avec l’IA, et vérifier chaque réponse (leçon 5)
 Google n’affiche plus les FAQ enrichies depuis mai 2026, mais une FAQ reste utile aux clients et aux IA. Rédigez la vôtre avec l’IA en 4 étapes.
De l’autre côté de la frontière
Nos pages de visibilité dans les IA pour le Grand Est et la frontière luxembourgeoise :
- Visibilité IA à Metz — être cité par ChatGPT, Gemini et Perplexity en Moselle
- Thionville et les frontaliers — être visible des deux côtés de la frontière
- Référencement IA en Moselle — un département, deux frontières, plusieurs marchés
- Nancy, Longwy et le Pays-Haut — deux marchés, deux stratégies de visibilité
L’IA et votre site — notre dossier
Ce que ça rapporte, et comment le mesurer
Être trouvé, et cité
Garder la main sur son contenu
Vous lisez info-lux régulièrement ?
Ajoutez info-lux.com à vos sources préférées : Google vous montrera plus souvent nos articles dans Actualités, Discover et ses réponses IA.
Ou par ce lien : ajouter info-lux.com comme source préférée.
